El problema
Un profesor de idiomas se pasa buena parte de la semana preparando material de práctica: veinte frases para completar sobre el dativo, un texto corto sobre un supermercado con cinco preguntas, un audio. Después lo corrige todo y, encima, intenta acordarse de qué alumno falla en qué tema.
ChatGPT en una pestaña del navegador ya escribe los ejercicios. Pero no sabe quiénes son sus alumnos, así que no puede decirle en qué tema flojea una clase, y todo lo que genera hay que repartirlo y corregirlo a mano.
Qué construí
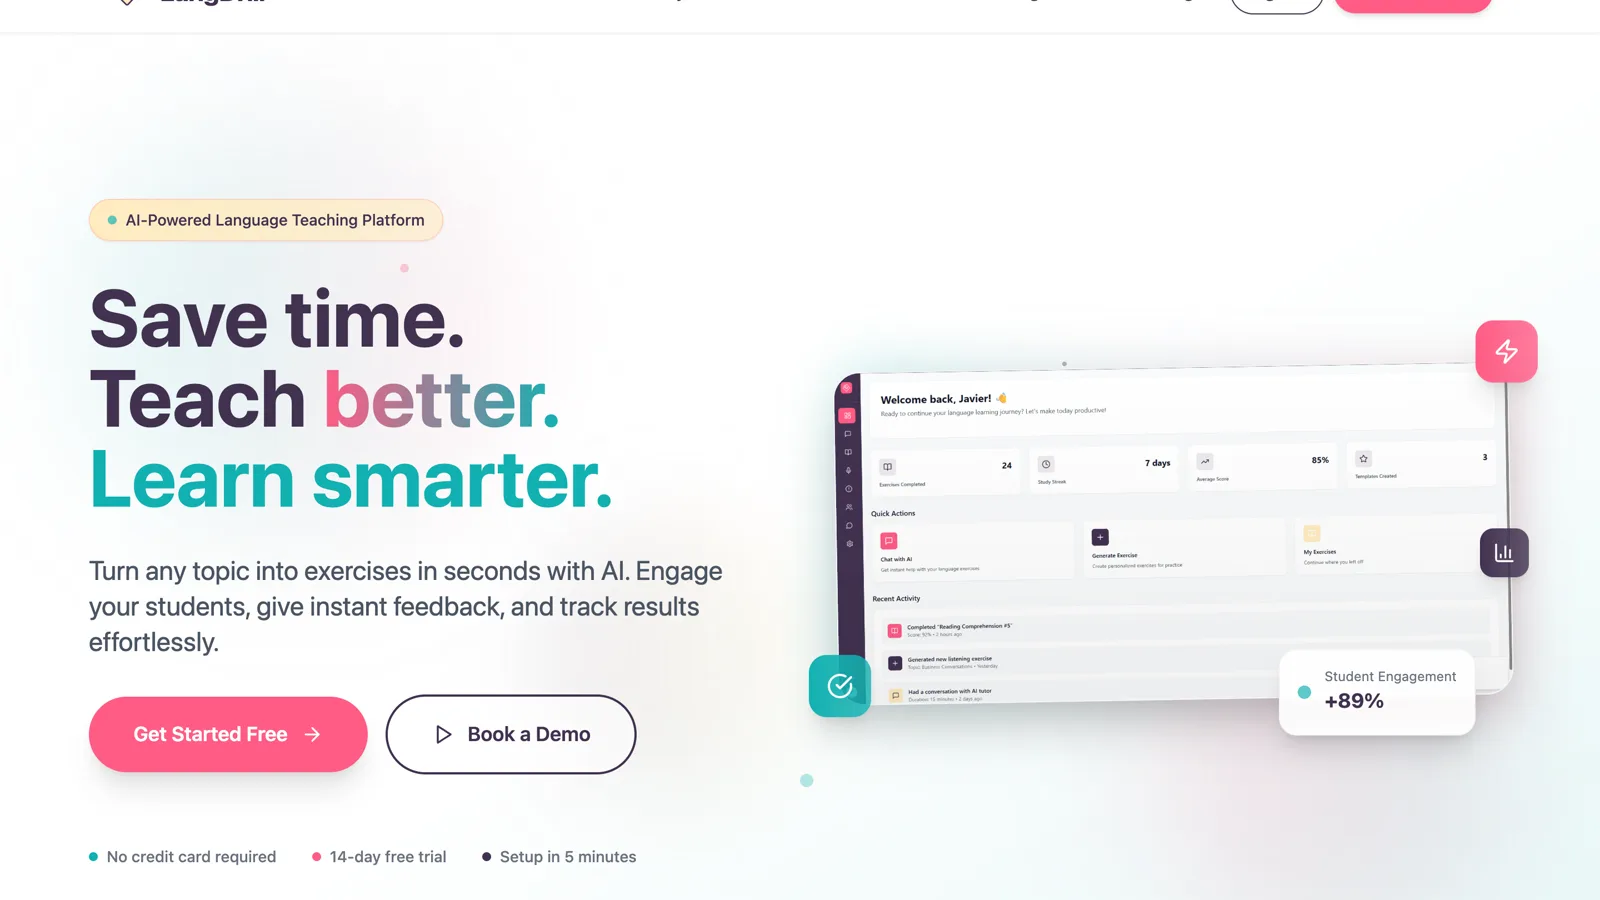
LangDrill es una web app que cierra ese ciclo. El profesor genera ejercicios, los agrupa en una plantilla, asigna la plantilla a un aula de alumnos, el modelo corrige cada respuesta y las notas se suman en estadísticas de la clase. Lo construimos Sebastian y yo en el verano de 2025: yo escribí el backend, los prompts y el esquema de la base de datos, y él entró en el frontend en julio (el repo está repartido casi a la mitad, 144 commits míos y 137 suyos).
Qué hace
- Genera ejercicios. De escritura, lectura y comprensión auditiva. El profesor elige idioma, nivel del MCER, número de ítems, una variante (completar huecos, reordenar frases, conjugación) y un tema, y revisa el resultado antes de guardarlo.
- Agrupa y asigna. Los ejercicios van a plantillas, y las plantillas se asignan a aulas.
- Corrige. Cada respuesta se evalúa, con una o dos frases de feedback por error y un consejo de gramática.
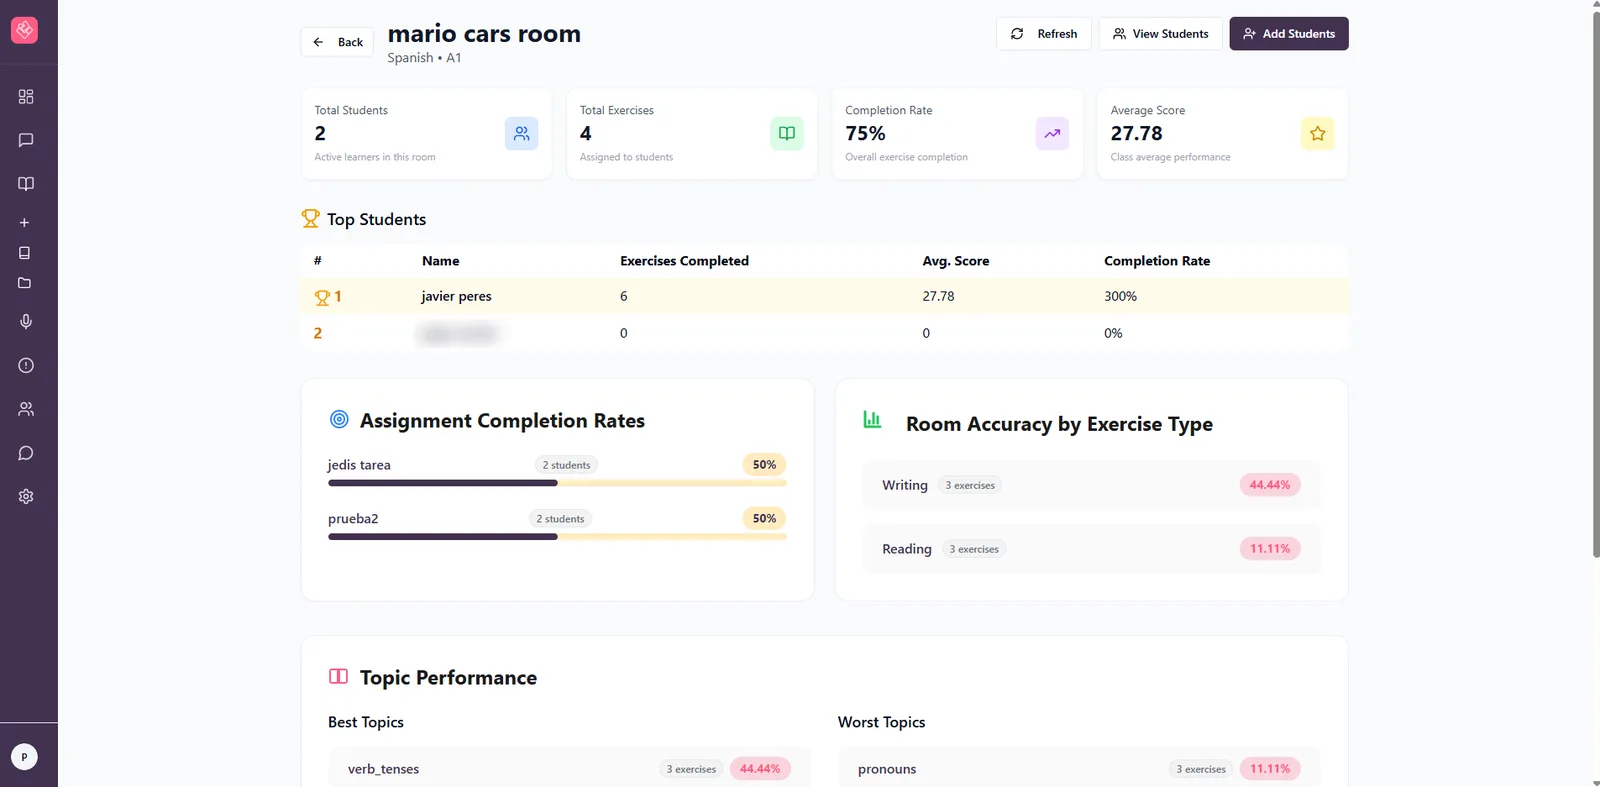
- Muestra dónde flojea una clase. Cada aula tiene una página con los mejores alumnos, el porcentaje de tareas completadas, el acierto por tipo de ejercicio y los mejores y peores temas gramaticales.
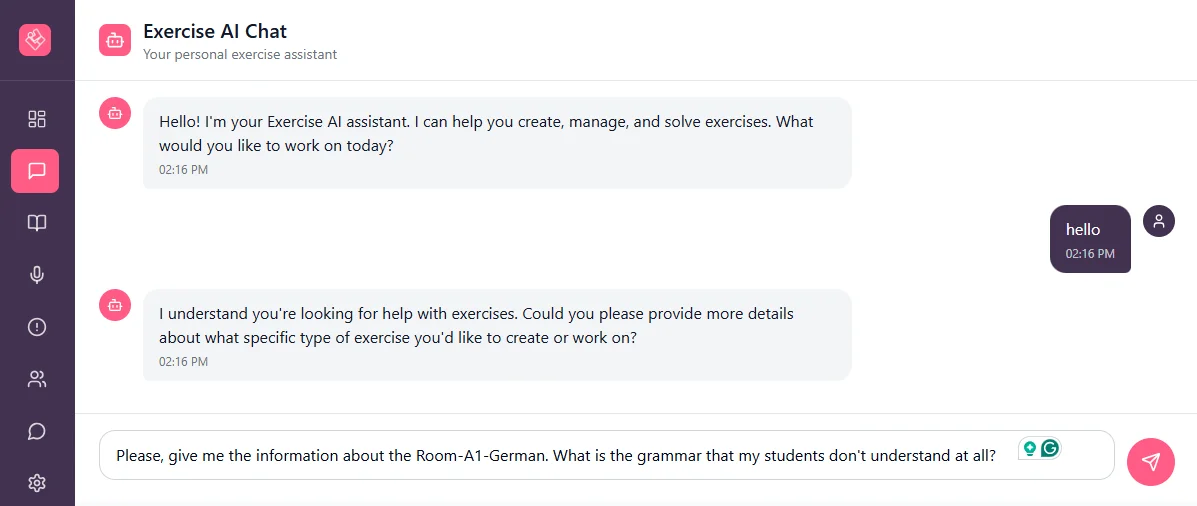
- Responde preguntas sobre tus datos. Una pantalla de chat para cosas como "¿qué gramática no entienden mis alumnos?".
Por qué estas herramientas
OpenAI genera y corrige, y cada endpoint devuelve una única forma de JSON estricta, así que el frontend puede pintar cualquier ejercicio sin adivinar. Mi primera versión era un chatbot que sacaba la petición del profesor con búsqueda de palabras clave. Era un formulario con pasos extra, así que en una semana se convirtió en un formulario, y el chat pasó a un lado.
Supabase guarda profesores, aulas, alumnos y notas. Su row-level security (reglas de Postgres como "un profesor solo ve las aulas que son suyas") es lo que tiene que separar los datos de un profesor de los de otro. FastAPI está entre el frontend y el modelo, para que los prompts y las claves se queden en el servidor. Brevo manda los correos de clase, Railway corre el backend y Vercel el frontend en React.
Lo difícil
El panel depende de un solo campo. Cada ejercicio corregido vuelve con un grammar_topic, y la página del aula agrupa las notas por él. Eso solo funciona si todos los ejercicios de pronombres llevan la etiqueta pronouns, siempre. Le di al modelo una lista cerrada de 67 temas gramaticales en seis idiomas, y aun así etiquetaba el ejercicio con lo que el alumno había fallado en vez de con su tema, y se inventaba temas nuevos cuando nada encajaba. Hicieron falta siete commits al endpoint de corrección en una tarde hasta que el prompt dijo, en mayúsculas, "DO NOT invent a new topic". Una lista fija se lee peor que el texto libre, pero se puede contar.
La otra lección fue con la base de datos. Al principio el backend usaba un único cliente de Supabase compartido, así que las reglas por fila no sabían quién preguntaba. Cuando llegaron los logins reales, pasé a un cliente por petición con el token del usuario. Eso arregló el bug, pero no hizo la app segura, y no vi lo lejos que estábamos hasta un año después.
En qué se convirtió
A finales de agosto de 2025 LangDrill tenía logo nuevo, deploy en Railway, una landing en langdrill.com y Brevo mandando los correos de clase. Después los commits se paran. Los siguientes son una licencia en noviembre y un README en febrero.
En julio de 2026 lo retomamos. Junté los repos de frontend y backend en una sola imagen desplegable, escribí la documentación y un known-issues.md, y planifiqué lo siguiente: un lector interactivo, convertir cuadernos de ejercicios escaneados en ejercicios, y práctica por voz (OpenAI Realtime por defecto, ElevenLabs como respaldo). Sebastian construyó la mayor parte en tres días: colas de trabajos con Redis, Docling para leer PDFs, un lector de libros con búsqueda de palabras, listas de vocabulario y una página de chat por voz. El plan de depuración del repo empieza con un PDF de 120 KB atascado en queued durante 20 minutos, así que esa parte todavía está en obras.
La revisión detrás de ese archivo encontró diecinueve funciones de la base de datos que se saltan la row-level security y se fían de un ID de usuario que manda quien llama, así que un alumno podía leer ejercicios de tareas que no eran suyas. Está todo por escrito, con nombres de archivo.
No tengo cifras de uso para poner aquí. La landing está en línea, el ciclo de generar a corregir funciona de punta a punta y la documentación es honesta con los agujeros.